

こんにちは、26Bのたいがです。
今回、Preferred Networks(PFN)が公開した国産LLM pfnet/plamo-3-translate-0.8b をベースに、離散拡散モデルをドラフト、元モデルをターゲットとする投機的デコードを実装しました。さらに、PyTorch / Tritonによるカーネル最適化も組み合わせた結果、870.4 tok/s(BF16版vLLM比 約1.75倍) を達成できたので、その手法について書いていきます。
なお、測定環境は NVIDIA H100 MIG 4g.47gb(64 SM)で、ウォームアップ後の Batch size 1・greedy生成で計測しています。
1. やり始めたきっかけ
プロジェクト開始前の11月8日、Xで「Qwen3.8-27Bを離散拡散モデル化した」という投稿を見かけたのがきっかけです。
そもそも、通常のLLMの自己回帰生成は1トークンずつ直列に計算するため、推論に時間がかかります。しかし、翻訳タスクには「原文」という強いコンテキストがすでに与えられているため、出力の骨格や語順もある程度絞られます。また、PLaMo翻訳では繰り返しの自己蒸留が使われているので、予測分布も尖っているんじゃないか?とも思っていました。そこで、「それなら数トークン先までまとめて予測しても高確率で当たるのでは?」と思い、離散拡散モデルと投機的デコードの組み合わせを思いつきました。
その後、先行研究を調べたところ、まさに同じ発想の論文 Unlocking Lossless Speedups in LLMs via Discrete Diffusion が見つかりました。そのため、これを参考に元モデルの重みを共有しつつ並列提案を行うアーキテクチャを実装してみました。
2. 重みを共有するToken-Gated LoRA
今回は独立したドラフトモデルを別途用意するのではなく、元モデルの重みを凍結したままLoRAだけを学習し、単一モデルに並列提案の能力を持たせる構成を採用しました。一方で、検証フェーズではLoRAを無効化し、元の自己回帰(AR)モデルとしてそのまま動かします。
具体的な推論の流れとしては、まず確定済みの文脈にノイズ(ランダムなトークン)を連結して入力し、1回のforwardで8トークン分の候補を並列に予測します。次に、LoRAを無効化した元のARモデルでそれらの候補をまとめて検証します。そして、左から順に一致する候補を採用し、不一致が出た位置のトークンをAR側の予測に置き換え、それ以降の候補を破棄します。
Token-Gated LoRA
各線形層のフォワードパスでは、LoRAの差分を加えるかどうかをトークン位置ごとに切り替えます。
ここで は1つの線形層の入力・出力にあたる中間表現です。
- :凍結されたベース重み(BF16)
- :学習対象の低ランク行列(Rank 16, FP32)
- :スケーリング係数
- :位置ゲート
具体的には、通常のクリーンなトークン位置では としてLoRAを無効化し、元のARモデルとして動作させます。反対に、ノイズを入れて未来のトークンを並列予測させる位置では とし、LoRAの差分を加えます。なお、LoRAはAttentionのQKV / Output Projectionと、MLPのGate / Up / Down Projectionに挿入しました。
なお、学習時はg=0の位置もLoRAを計算し、最後にゲートを掛けています。g=1の位置だけ計算する方法もありますが、対象を絞ると行列積が小さくなってGPUの計算効率が落ちるうえ、取り出し・書き戻しにもコストがかかります。最適化は可能かもしれませんが、今回は予想される影響が非常に小さかったのと、推論時の速度向上を見込めるものではなかったため、これについての実験はしていません。
LoRAのサイズと学習パラメータ数
LoRAは (スケーリング係数 )に設定しました。LoRAの差分は「入力 → 16次元 → 出力」の2段の全結合層で計算します。
実装上はQ・K・Vを1つのQKV Projectionに、MLPのgate・upを1つのGate/Up Projectionにまとめており、それぞれに1組ずつLoRAを挿入しています。そのため、Transformer 1層あたりの内訳は次のとおりになります。
| 対象 | 入力次元 | LoRAの中間次元 | 出力次元 | 学習パラメータ数 |
|---|---|---|---|---|
| QKV Projection | 1,536 | 16 | 2,304 | 61,440 |
| Output Projection | 2,048 | 16 | 1,536 | 57,344 |
| Gate/Up Projection | 1,536 | 16 | 12,288 | 221,184 |
| Down Projection | 6,144 | 16 | 1,536 | 122,880 |
| 1層の合計 | 462,848 |
これを全16層の4か所ずつ(計64か所)に挿入したため、学習パラメータは合計 7,405,568個(約741万) です。ただし、学習するのはこれらのLoRA行列(FP32)のみで、トークンEmbeddingや語彙Headを含む元モデルのパラメータ(BF16)はすべて凍結しています。
3. 学習データと予測分布
学習用の原文を集める
本格的な学習に向けて、日英・英日の原文を FineWeb、FineWeb2、FineWeb2 Edu Japanese、Wikipedia、JParaCrawl、JESC、mC4/C4、FineWeb-Edu などのコーパスから合計約0.75Bトークン収集しました。
まず、収集したテキストには文字化け・言語不一致・過度な反復などのフィルタをかけたうえで、正規化後の完全重複および近似重複を除去しています。さらに、学習用と検証用は原則として文書単位で 9:1 に分割し、同一文書の別段落が混入することによるデータリークを防ぎました。ただし、作品単位のIDが取得できなかったJESCのみ、公式のtrain分割から取得して学習側に限定しています。
原文から教師翻訳を作る
JParaCrawlやJESCには対訳が含まれていますが、今回は日本語側と英語側をそれぞれ独立した原文として扱い、教師用の翻訳はPLaMo自身に生成させました。元モデルの予測を近似するためのデータなので、今回は元モデル自身が生成したトークン列を使っています。
そのため、学習時はノイズを加えていない既知のトークン列(クリーンなPrefix)に対するARの出力分布 を教師とし、ノイズブロックを与えたドラフト側の出力分布 が対応する位置の に近づくように学習します。
教師生成が終わらなかった例
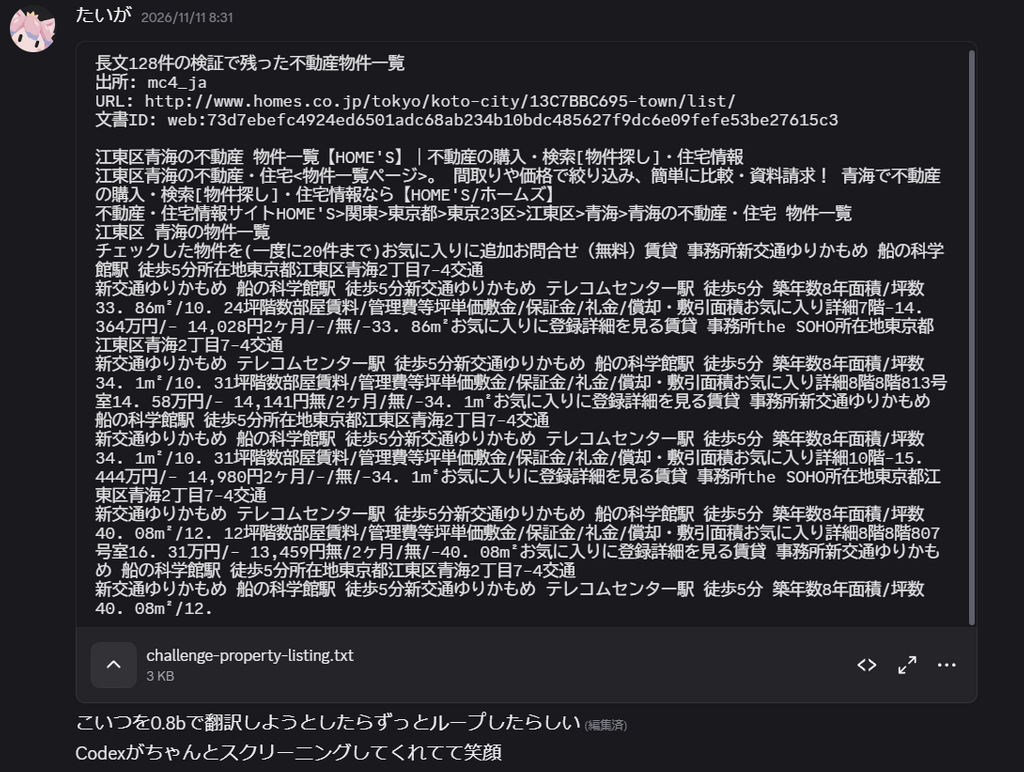
長さ制限に達した128件を検証したところ、上限2,048トークンで126件、4,096トークンでさらに1件がEOSに到達しました。しかし、mC4に含まれていた長い不動産物件一覧が1件最後まで残り、元のARモデルが同じ賃貸物件のフレーズを延々と反復してしまい、4,096トークンでも終わりませんでした。LLMの宿命であることは知っていましたが、0.8Bとはいえ翻訳用LLMが反復ループ現象を起こすことがあるんだなと驚きました。
1回のforwardで教師とドラフトを計算
学習時は、教師用のクリーンなトークン列と複数のノイズブロックを1つの入力テンソルに詰めてforwardします。このように配置したうえで、クリーンな位置ではLoRAを無効、ノイズ位置では有効に切り替えることで、1回のforwardから教師とドラフト両方の中間表現を取り出せます。
しかし、この配置に通常のCausal Maskを使うと、後ろに配置したノイズ位置から「その時点では未知であるはずの未来のクリーンな正解トークン」まで見えてしまいます。そこで、配置順に加えて各トークンの論理位置とノイズブロックのIDを用いた専用のAttention Maskを作成しました。これにより、クリーン列は過去と現在のクリーン位置だけを参照し、ノイズ位置は「ブロック開始前のクリーン列」と「同じブロック内の自身以前の位置」だけを参照できるようになります。
損失関数
全語彙に対する予測確率のL1距離は、投機的デコードのドラフトモデルの学習で使われる損失の一つです。これはTV(Total Variation)距離の2倍にあたります。今回参考にした離散拡散の論文でも、このL1距離をTV損失として使っています。
元モデルの予測分布を 、ドラフトの予測分布を とすると、確率的な投機的サンプリングにおける1トークンの採択確率は次のように表せます(Leviathan et al., 2023)。
したがって、このサンプリング方式ではL1距離を小さくすることが採択確率の向上に直接結びつきます。
ちなみに、これをMTP(Multi-Token Prediction)に用いる研究を、PFNの岡野原さんがXで紹介しています。
ただし、今回のgreedy生成ではargmaxが一致した候補を採択するため、学習時のL1距離からgreedy生成の採択率を直接算出できない点に注意してください。
また、PLaMoの語彙数は107,520と大きいため、学習中に多くの予測位置をまとめて処理すると「予測位置数 × 107,520」の巨大なロジットテンソルがVRAMを圧迫します。そこで、語彙Projection層では一度に処理する予測位置を小分けにし、チャンクごとに全語彙のロジットと損失を計算しました。こうすることで、語彙を削ることなく巨大なロジットテンソルの同時保持を回避しています。
さらに、逆伝播に必要なロジットや予測確率は、保存しておいた中間表現から再計算します。また、損失計算の時点でロジットに対する勾配も先に求め、保存量に上限を設けてキャッシュしました。そして、キャッシュした勾配を逆伝播で再利用することで、語彙Projectionやsoftmaxの再計算コストを削減しています。
4. KVキャッシュの確定範囲と1トークンのズレ
並列提案とAR検証を組み合わせる際、最もバグを生みやすいのがKVキャッシュのライフサイクル管理です。そこで、ドラフトが作った一時KVと、検証後に次のサイクルへ引き継ぐ確定KVの境界を整理しておきます。
たとえば、既知のトークン列を とし、 を末尾 より前のトークン列とします。この実装では、サイクル開始時の確定KVは の分までで、末尾 のKVはまだ計算されていません。
ここで、提案した が採用され、3番目が に修正された場合を考えます。このとき、確定したトークン列は になりますが、確定KVは の分までとなります。
一時KVとPending Tokenの扱い
- 一時KVの破棄:提案フェーズで作ったノイズ混じりのKVは即座に破棄(discard)し、検証フェーズでクリーンな入力 から再計算したKVのうち、採用された範囲だけを引き継ぎます。
- Pending Token:AR側で候補を棄却して選び直したトークン は、出力としては確定していますが、 自身のKVはまだ計算されていません。
したがって、この方式で生成を続ける間、確定KV長 と確定済みトークン列の長さ の間には常に次の関係が成り立ちます。
つまり、末尾の は「出力は確定済み・KVは未計算」の Pending Token として保持し、次のサイクルのアンカーにします。そして、次サイクルの検証時に を入力に含めることで初めて のKVが確定し、今度は新しく確定した末尾トークンが次のPending Tokenになります。こうして、「出力の末尾1トークンだけがKV未計算」という状態をサイクルごとに引き継いでいきます。
5. 推論の高速化
ボトルネック分析
高速化の方針を立てるうえでは、Horace Heの Making Deep Learning Go Brrrr From First Principles にある「処理時間を Compute・Memory・Overhead の3つに切り分ける」視点が参考になります。なぜなら、演算そのもの、データ転送、CPUからのカーネル起動のどこが支配的かによって、打つべき手が変わるためです。
今回のようなバッチサイズ1のデコードは、典型的なメモリバウンド(Memory-bound)のワークロードです。入力の行数が少ないProjectionでは一度に処理するトークン数が少なく、HBMから読み出した大きな重み行列を十分な回数使い回せません。そのため、H100の演算性能が高くても、重みの読み出し帯域が律速になります。
最適化手法
CUDA Graphsと静的バッファの再利用
まず、CUDA Graphsでデコード処理をキャプチャし、CPUからのカーネル起動オーバーヘッドを削減しました。リプレイ時に同じメモリアドレスを参照する必要があるため、入力やKVキャッシュのバッファ領域を固定し、中身だけを書き換える構成にしています。
また、PrefillにもCUDA Graphsを適用し、入力トークン数に応じて 32・64・128・256・512 のバケットを用意しました。具体的には、入力が収まる最小のバケットを選択し、余剰分はパディングします。ただし、パディング領域は確定済みのKVキャッシュには含めず、実際のPrefix長までを有効範囲として扱います。なお、512トークンを超える入力のみ通常の実行経路へフォールバックします。
カーネルの垂直融合(Fused Kernels)
次に、カーネルの起動回数と中間テンソルのHBMへの書き出し・読み戻しを減らすため、以下の3組をそれぞれ1つのカーネルに融合しました。
Q/K Normalization + RoPE + KV書き込みSiLU + Gate積Residual + RMSNorm
語彙HeadでのProjectionとArgmaxの融合
greedy生成ではsoftmaxを計算せず、ロジットのargmaxからToken IDを選べます。ちなみにgreedyではなく一般のtop-kの場合もsoftmaxを計算せずに選ぶことが可能で、実際にvLLMではこの方法が使われています。
今回は、このArgmaxを語彙Projectionに融合し、全ロジットのグローバルメモリへの書き出し・読み戻しを省きました。107,520語彙をタイルに分け、Projectionで得たロジットをオンチップでReductionして「各タイルの最大値とそのToken ID」だけを書き出します。最後に、タイルごとの候補から全体の最大値を選び、最終的なToken IDを確定します。
提案側のRow-scaled FP8化
さらに、メモリバウンドへの対策として重みを量子化し、HBMから読み出すバイト数を削減しました。今回は候補を生成する提案側(Draft)のみを量子化し、出力を確定する検証側(Target)はBF16のまま維持しています。提案側の量子化によって候補や採択率は変化しますが、最終的な出力はBF16の検証結果に従って確定するため、生成品質の無劣化が保証されます。ただし、提案が速くなっても棄却率が増えれば全体では遅くなるため、生成全体のスループットを計測したうえで採用を判断しました。
具体的には、提案側のQKV・O・Gate/Up・Draft Headに、行ごとにスケール係数を持つRow-scaled FP8を採用しました。重みは出力チャネルごと、入力はトークン位置ごとの行単位でFP8へ量子化しています。一方で、MLPのDown Projectionのベース計算はBF16のまま維持し、LoRAの計算にはBF16の一時コピーを使用しました。
また、入力のFP8化は行ごとに1回だけ実行して各タイルで使い回し、入力行と重み行のスケール係数は行列積の結果に対してまとめて乗算しています。
こうして複数の計算経路を比較検証した結果、最終的には「FP8でHBMから読み出し、オンチップでFP16へ変換して FP16 MMA + FP32累積 で計算する」方式を採用しました。実際、量子化や型変換のオーバーヘッドを含めて実測したところ、今回のような小行数のワークロードではこの経路が最速でした。
小行数に合わせたタイリング
行列積の実装では、Simon Boehmの How to Optimize a CUDA Matmul Kernel で解説されているMemory Coalescing、Shared Memoryへのキャッシュ、Block/Warp Tilingなどの手法を参考に、Projectionごとにタイルサイズと値の再利用を調整しました。
ただし、大きな正方行列のGEMMで速い設定をそのままデコードに持ち込むことはできません。というのも、今回は入力トークン数が少ないため、タイルを大きくして再利用を増やそうとすると、パディング領域の無駄な計算やレジスタ・Shared Memoryの消費が膨らんでしまうためです。
そこで最終的に、FP8読み出し経路には行方向を16行単位のタイルで扱い、FP16 MMAで計算するカーネルを採用しました。比較対象として、H100のネイティブFP8 WGMMAで計算するカーネルも実装し、FP8をオペランドとする命令が生成されることまで確認しました。しかし、こちらは64行単位のタイルになり、小行数の入力ではパディングによる余分な計算が増えたため、生成全体では16行タイルのFP16 MMA経路よりも低速になってしまいました。
6. ベンチマーク結果
- 測定環境:NVIDIA H100 MIG 4g.47gb(64 SM)。5方式すべてを同じGPU枠で測定しました。
- 評価入力:Wikipediaの科学・情報技術・歴史・文化・社会基盤・経済の6分野から、日英24件+英日24件の計48件です。分野と記事を先に決め、固定seedで連続する文を抽出し、入力長だけで調整しました。翻訳結果や速度による選別はしていません。
- 入力長:プロンプト込みで1〜128、129〜256、257〜512、513〜1024トークンを各12件。
- 測定条件:Batch size 1、greedy生成、全入力をウォームアップした後、各方式を5回ずつ測定しました。
- 時間計測範囲:Prefill開始からDecode完了・HostでToken IDを受け取るまでを計測しました。
- 集計方法:実際に生成した全トークン数÷全リクエストの計測時間の合計で計算。Token IDの数にはEOSを含めています。
| 手法 | 精度構成 | 生成速度 (tok/s) | BF16版vLLM比 | 5回の速度範囲 (tok/s) |
|---|---|---|---|---|
| vLLM | BF16 | 496.6 | 1.00x | 495.7〜497.0 |
| 独自 AR | BF16 | 510.0 | 1.03x | 509.8〜510.2 |
| 並列提案(Block 8) | 提案 BF16 / 検証 BF16 | 767.6 | 1.55x | 767.3〜767.8 |
| 並列提案(Block 8) | 提案 FP8 / 検証 BF16 | 870.4 | 1.75x | 870.3〜870.7 |
比較の基準はBF16版vLLM=1.00倍です。提案FP8・検証BF16の並列提案方式は、同条件のBF16版vLLMに対して1.75倍でした。ただし、vLLMとの比較は出力が異なる場合を含む生成速度の比較です。
ちなみに、同条件で計測した、vLLM(公式FP8重み)の生成速度がおよそ626.1tok/sで、これと比べても高速に生成できています。
| 手法 | 1回分の出力トークン数 | EOS到達リクエスト | 上限打ち切り | 独自ARと一致した入力の数 |
|---|---|---|---|---|
| vLLM(BF16) | 19,028 | 240/240 | 0 | 14/48 |
| 独自AR(BF16) | 19,025 | 240/240 | 0 | 48/48 |
| 並列提案(提案BF16) | 19,025 | 240/240 | 0 | 48/48 |
| 並列提案(提案FP8) | 19,025 | 240/240 | 0 | 48/48 |
出力の一致はトークン列を比較した結果で、翻訳品質について保証することはできません。EOS到達と打ち切りの件数は、5回の測定を合計した値です。
出力が一致しない要因としては、最適化によって計算の順序が変わったことによる丸め誤差などが考えられます。
なお、BF16版vLLM同士でも、同じモデル・入力・生成設定で出力が変わることがあります。H100のMIG区画が4g.47gb(64 SM)から3g.47gb(60 SM)に変わった環境で同じ48件を再実行したところ、出力トークン列が完全一致したのは20/48件でした。
平均採択長
平均採択長は、修正・追加の1トークンを含めず、先頭から一致して採用したドラフトトークン数をサイクル数で割った値です。最後のEOSを含むサイクルも数えています。提案側のBF16とFP8は同じLoRA・同じ入力で比較しました。
| 方向 | 提案精度 | 平均採択長 / 8 | 確定トークン / cycle | 提案 (ms/cycle) | 検証 (ms/cycle) |
|---|---|---|---|---|---|
| 日英 | BF16 | 2.35 | 3.35 | 2.333 | 2.003 |
| 日英 | FP8 | 2.30 | 3.29 | 1.746 | 2.004 |
| 英日 | BF16 | 2.48 | 3.47 | 2.348 | 2.018 |
| 英日 | FP8 | 2.42 | 3.41 | 1.760 | 2.018 |
提案・検証時間はCUDAイベントを入れた別の診断実行で計測したGPU内の時間です。いずれもforwardと語彙Headを含み、Prefillと採択後の処理は含みません。
全体の平均採択長は、提案BF16で2.42、提案FP8で2.36でした。生成全体の速度は767.6→870.4 tok/sです。FP8化で採択長は少し下がったものの、提案にかかる時間が短くなり、全体では速くなりました。今回は、多少外しても速く候補を作る方が得でした。
7. まとめ
モデルの学習と限界ぎりぎりのカーネル最適化を突き詰めた結果、今回の測定では約870 tok/sまで推論速度を引き上げることができました。
vLLMなどの推論エンジンの実装を深堀りしながら追ったことで、どのようなテクニックが使われているか、GPU最適化についてどんな方法があるのか、この記事に載せたもの以外でもいろいろ知ることができ、楽しかったです。
ある程度の性能が出るようになってきて満足したのでモデルの学習を打ち切りましたが、まだ安定して検証損失が下がり続けていたので、さらに時間をかければドラフトの採択率や生成速度ももっと上がっていたかもしれません。
ちなみに、今回はバッチ推論については取り扱いませんでしたが、離散拡散モデルをバッチ化すると、タイミングを合わせるのが難しいこと(arXiv:2607.08930)や、ARに対する推論速度の優位が小さくなったりすることが知られており、クラウド推論ではあまり主流ではないようです。
